Новости
Apple выпустила новый визуальный энкодер FastVLM
Apple опубликовала FastVLM — визуальный энкодер, которая позволяет улучшить работу с большими мультимодальными языковыми моделями.
Apple опубликовала FastVLM — визуальный энкодер, которая позволяет улучшить работу с большими мультимодальными языковыми моделями.
Visual Language Model (VLM) — это модель искусственного интеллекта, которая сочетает в себе обработку изображений (визуальных данных) и текста (языковых данных). Такие модели умеют одновременно анализировать и понимать как картинки, так и текст, что позволяет им выполнять мультиформатные задачи.
VLM использует два типа нейросетей:
- Визуальный энкодер — преобразует изображение в векторное представление.
- Языковая модель — обрабатывает текст и встраивает его в общий векторный контекст вместе с визуальными данными.
FastVLM как раз является новым визуальным энкодером, разработанным для вывода меньшего количества токенов и значительного сокращения времени энкодинга изображений высокого разрешения.
Модель доступна в конфигурациях с параметрами 0,5B, 1,5B и 3B.
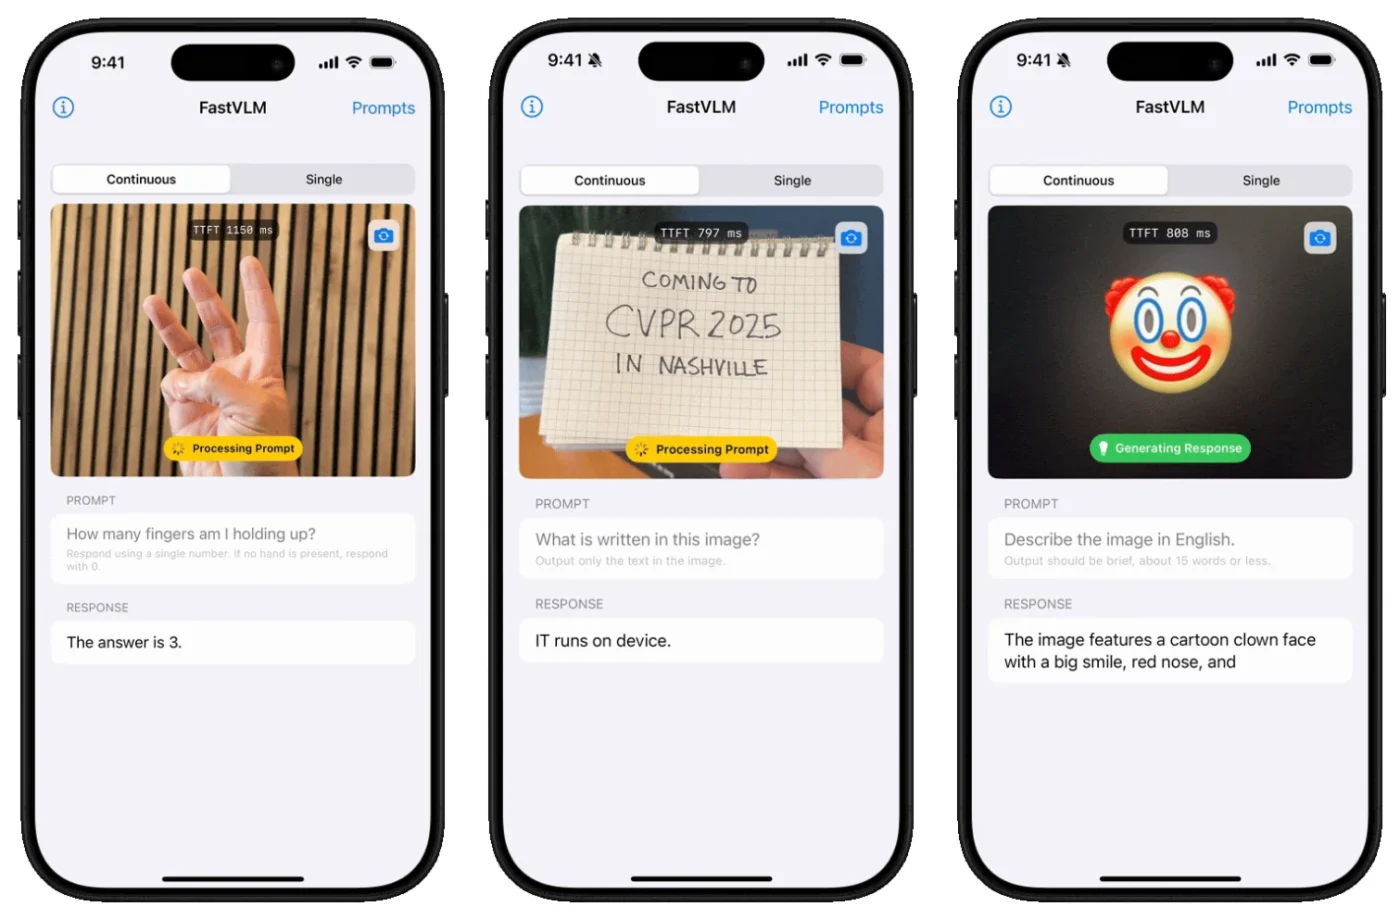
Apple также предоставила демонстрационное приложение для запуска модели на устройствах Apple и распознавания изображения.
-
 Разработка3 недели назад
Даем ИИ видеть SwiftUI: Xcode Preview MCP на практике — проблемы и надежды
-
 Новости4 недели назад
Видео и подкасты о мобильной разработке 2026.39
-
 Новости3 недели назад
Видео и подкасты о мобильной разработке 2026.40
-
 Новости2 недели назад
Видео и подкасты о мобильной разработке 2026.41