Новости
Inception представила Mercury 3 — диффузионную LLM, которая превосходит GPT-6 Luna, Claude Haiku 5.5 и GLM-5.3 Flash и работает в 4–8 раз быстрее
Остаётся главный вопрос: окажется ли эта технология нишевым решением для приложений, где ИИ должен работать в реальном времени, или в долгосрочной перспективе станет серьёзным конкурентом самым передовым моделям.
Пока индустрия ИИ делает огромную ставку на LLM и гигантские дата-центры, необходимые для их масштабирования, одна из новых лабораторий, выбравших альтернативный путь развития ИИ, выпустила ещё одну модель, которая ставит под сомнение такой подход.
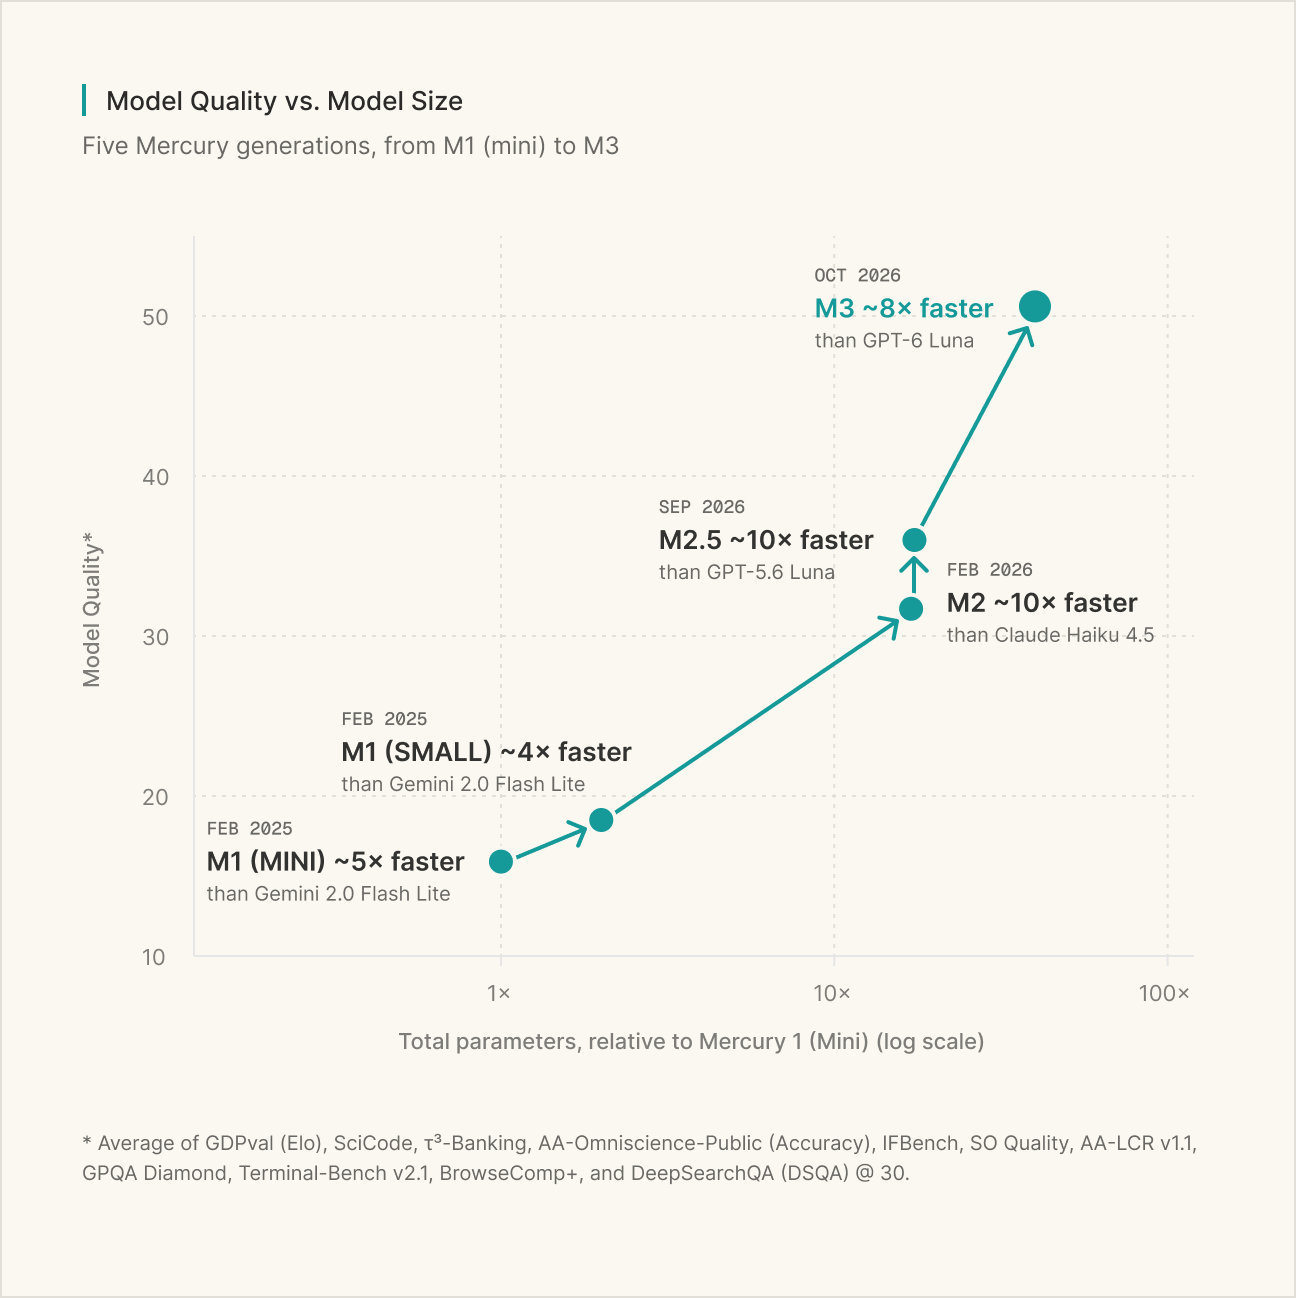
В понедельник Inception представила Mercury 3 — свою новую флагманскую модель. Это диффузионная LLM, которая использует технологию, отличную от традиционных LLM, генерирует текст значительно быстрее и дешевле, а по производительности и качеству уже сравнялась с младшими и средними моделями Anthropic и OpenAI. Inception также сообщила, что задействовала рои агентов Mercury 3 для рекурсивного самоулучшения, благодаря чему общая скорость модели выросла ещё на 16% сверх улучшений, реализованных самой командой Inception.
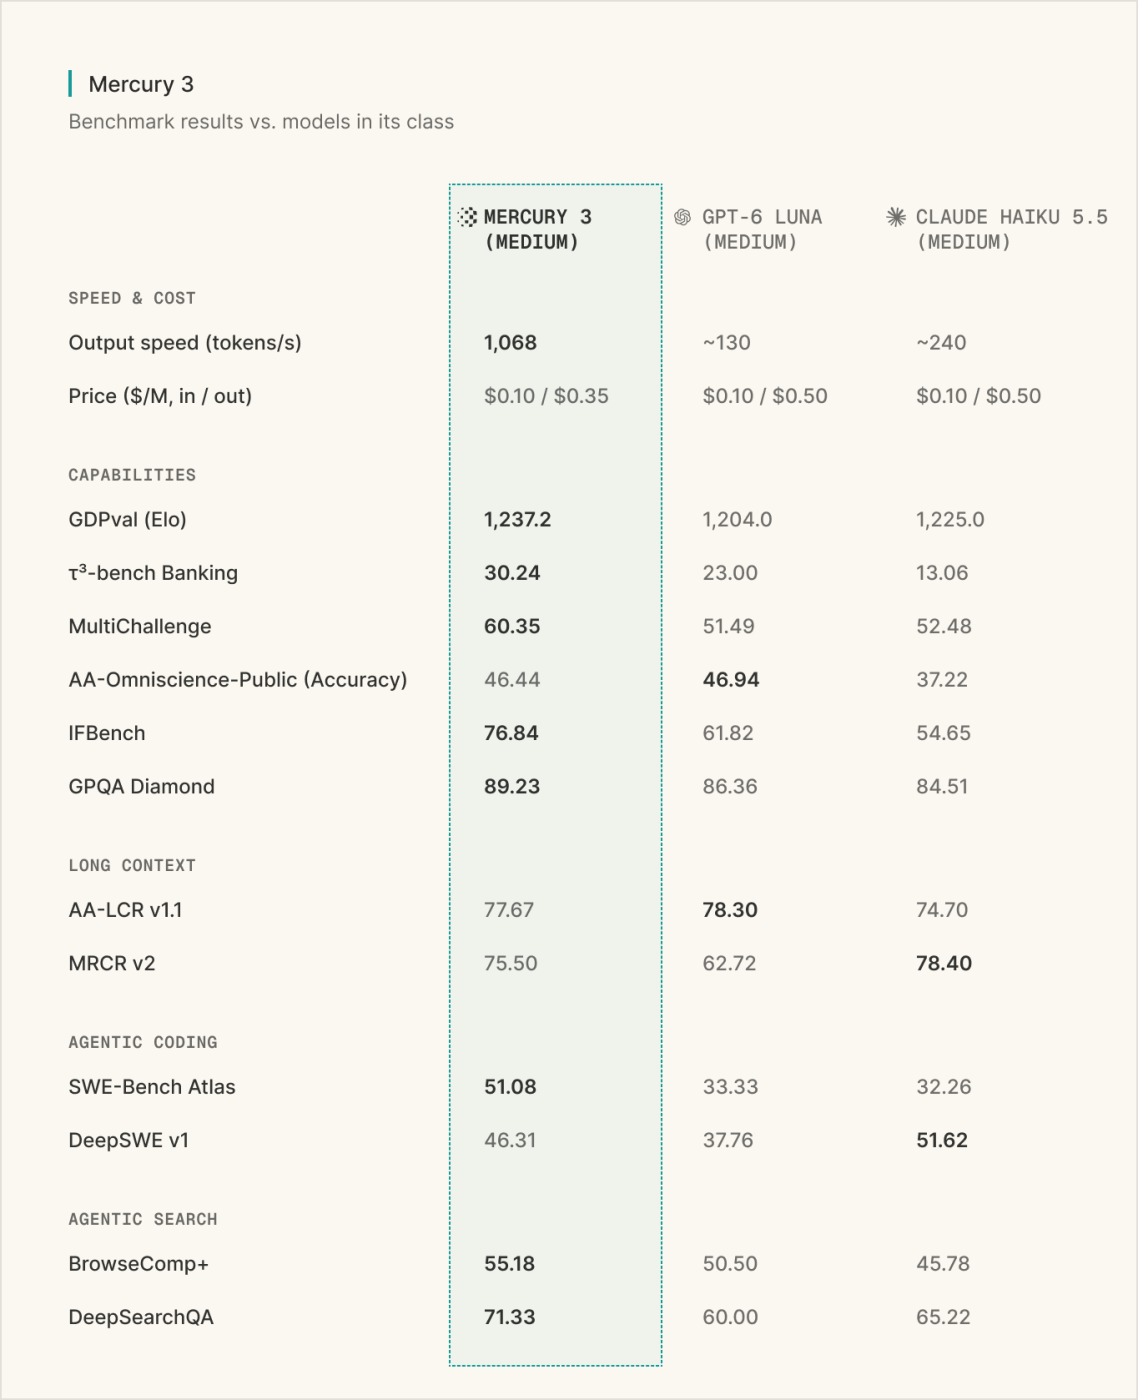
«Mercury 3 — самая мощная диффузионная языковая модель на рынке, — рассказал генеральный директор Inception Стефано Эрмон. — Она очень умная. По возможностям она сопоставима с моделями Luna и Haiku, но при этом намного быстрее. Она выдаёт около 1 000 токенов в секунду. Ответы от таких моделей появляются практически мгновенно».
Mercury 3 стоит $0,10 за миллион входных токенов и $0,35 за миллион выходных. По сравнению с ведущими моделями Anthropic Haiku 5.5 и OpenAI GPT-6 Luna цена входных токенов такая же, а выходных — на 35% ниже. Однако это стартовая цена Mercury 3, которая на 50% ниже будущей стандартной стоимости. Inception пока не сообщила, как долго продлится стартовая акция. Но Эрмон рассказал , что компания работает над улучшениями, которые могут позволить сделать стартовую цену постоянной уже в ближайшие недели.
Однако воспринимать Mercury 3 просто как дешёвую модель было бы неправильно. Anthropic и OpenAI предлагают сниженные цены на свои бюджетные модели, чтобы иметь недорогие варианты, одновременно устанавливая заметно более высокие цены на самые мощные модели. Mercury 3 — флагманская модель Inception, и её главное преимущество — прежде всего скорость, а не цена. Inception утверждает, что Mercury 3 работает в 4–8 раз быстрее Haiku 5.5, GPT-6 Luna и GLM-5.3 Flash, одновременно превосходя их все в агентных бенчмарках.
Mercury 3 достигает этого за счёт параллельного инференса. Обычные LLM генерируют текст последовательно, по одному токену за раз. Это авторегрессионный процесс, в котором каждый следующий токен зависит от предыдущих. Mercury 3, напротив, способна одновременно генерировать и уточнять несколько токенов. Такой подход намного эффективнее использует огромные возможности GPU по параллельной обработке данных. Именно поэтому модели Inception могут выдавать ответы быстрее и дешевле. Диффузионные модели уже используются многими ведущими лабораториями для генерации изображений и видео. Прорыв здесь заключается в применении этой технологии к тексту.
Mercury 3 теперь использует в 40 раз больше параметров, чем Mercury 1, выпущенная в феврале 2025 года, однако команда Inception не раскрывает общее количество параметров модели. Вероятно, их число относительно небольшое, и Inception не хочет, чтобы люди сравнивали несопоставимые вещи и недооценивали модель. Тем не менее Mercury 3 показывает, что диффузионные LLM развиваются очень быстро и уже в следующем году могут приблизиться к традиционным пограничным LLM. Вероятно, именно поэтому Google DeepMind тоже незаметно работает над той же технологией и в июне выпустила DiffusionGemma. К слову, у неё 26 млрд параметров — совсем немного по сравнению с пограничными моделями на 1 трлн параметров, — но при этом она демонстрирует сходный с Mercury прорыв в скорости.
Mercury 3 ставит под сомнение нынешний подход большинства ведущих ИИ-лабораторий, которые сделали ставку на увеличение размеров LLM и рассчитывают, что дальнейший прогресс обеспечат всё более быстрые вычислители и их растущее количество от Nvidia и других производителей чипов. Если Inception права насчёт диффузионных LLM, последствия могут быть очень серьёзными. Главная дилемма ИИ-индустрии заключается в том, что повышение интеллектуальных возможностей моделей требует дополнительных вычислений — и очень большого их количества. Улучшение рассуждений и увеличение числа агентных шагов обычно одновременно повышают стоимость и время ответа. Поэтому прорыв Inception с диффузионными LLM сейчас в первую очередь заключается в более быстром отклике ИИ и более эффективном использовании дорогих GPU. Остаётся главный вопрос: окажется ли эта технология нишевым решением для приложений, где ИИ должен работать в реальном времени, или в долгосрочной перспективе станет серьёзным конкурентом самым передовым моделям.
-
 Разработка3 недели назад
Даем ИИ видеть SwiftUI: Xcode Preview MCP на практике — проблемы и надежды
-
 Новости4 недели назад
Видео и подкасты о мобильной разработке 2026.39
-
 Новости3 недели назад
Видео и подкасты о мобильной разработке 2026.40
-
 Новости2 недели назад
Видео и подкасты о мобильной разработке 2026.41