Разработка
Как команда Claude Code проводит проверку кода
Ранее мы уже говорили, что Claude пишет около 90% собственного кода Claude Code. Тогда возникает очевидный вопрос: как вообще проверять код при таких объёмах? Кто-нибудь ещё читает код? И если что-то ломается, кто это замечает?
Ранее мы уже говорили, что Claude пишет около 90% собственного кода Claude Code. Тогда возникает очевидный вопрос: как вообще проверять код при таких объёмах? Кто-нибудь ещё читает код? И если что-то ломается, кто это замечает?
В этой статье мы расскажем, как устроен code review в команде Claude Code и как этот процесс эволюционировал. С июня по сентябрь количество смердженных pull requests в кодовой базе Claude Code выросло более чем вдвое, а доля PR, которые пришлось откатывать, снизилась более чем на 40%.
Мы не убрали ревью. Но большую часть чтения кода передали машинам, оптимизировали процесс под человеческое время и внимание и серьёзно вложились в то, чтобы ошибки можно было быстро и легко отменять.
Переосмысляем цель Code Review
Когда код пишут агенты, количество изменений растёт очень быстро. В монорепе Anthropic число изменений, попадающих в main-ветку за день, выросло примерно с 2 500 в мае до более чем 30 000 в сентябре этого года.
Claude Code живёт в отдельном репозитории, а не в monorepo, но там давление тоже огромное. При такой скорости ручной построчный code review становится невероятно трудным, если вообще возможным.
Code review выполняет две задачи:
- Найти и исправить проблемы до того, как они попадут к пользователям.
- Создать общий контекст и понимание кодовой базы внутри команды.
Эта статья в основном посвящена первой задаче — поиску и исправлению проблем, но к второй мы ещё вернёмся ближе к концу.
Мы считаем, что вопрос «прочитал ли человек этот код?» — довольно неточный заменитель более полезного вопроса: «что может пойти не так с этим изменением и какая проверка — автоматическая или человеческая — лучше всего это поймает?»
Этот подход изменил и сам момент, когда происходит ревью. Раньше ревью было воротами в самом конце пути: написал код, открыл PR, ждёшь коллегу.
Теперь review идёт постоянно — скорее как проверка правописания во время набора текста. Большинство изменений уже хотя бы один раз проверены и исправлены Claude ещё до того, как их увидит человек. Это позволяет ловить большую часть рутинных ошибок автоматически и сохранять человеческое внимание для более сложных вопросов и действительно серьёзной проверки.
Дефицитный ресурс: человеческое время и внимание
Мы хотим сохранять человеческое время и внимание для проблем, которые может решить только человек, а всё остальное отдавать автоматическим проверкам. При нынешнем темпе изменений для людей всё равно остаётся огромное количество работы, а наша команда практически каждый день сталкивается с новыми задачами.
Человеческое время расходуется с двух сторон: люди тратят время на ревью, а затем ещё и на исправление последствий плохого кода. Сокращать первое бессмысленно, если затем всё это время просто появится во втором месте.
Поэтому наша цель состоит в том, чтобы большинство pull requests в репозиториях Claude Code — CLI, desktop- и web-приложениях, а также mobile-приложениях — могли merge-иться максимум с одним человеком в цикле, причём этим человеком может быть сам автор, и без роста числа откатов или инцидентов. Чтобы измерять человеческие затраты, мы отслеживаем количество одобрений людей на PR — медиану и 95-й перцентиль, количество человеческих комментариев и время, которое PR ждёт человека. А показатели revert и incidents служат ограничителем: если они растут, значит, мы не сэкономили человеческое время, а просто перенесли его в другое место.
Жизненный цикл изменения
Типичное изменение — от ноутбука инженера или сессии Claude в Slack — проходит через несколько уровней code review.
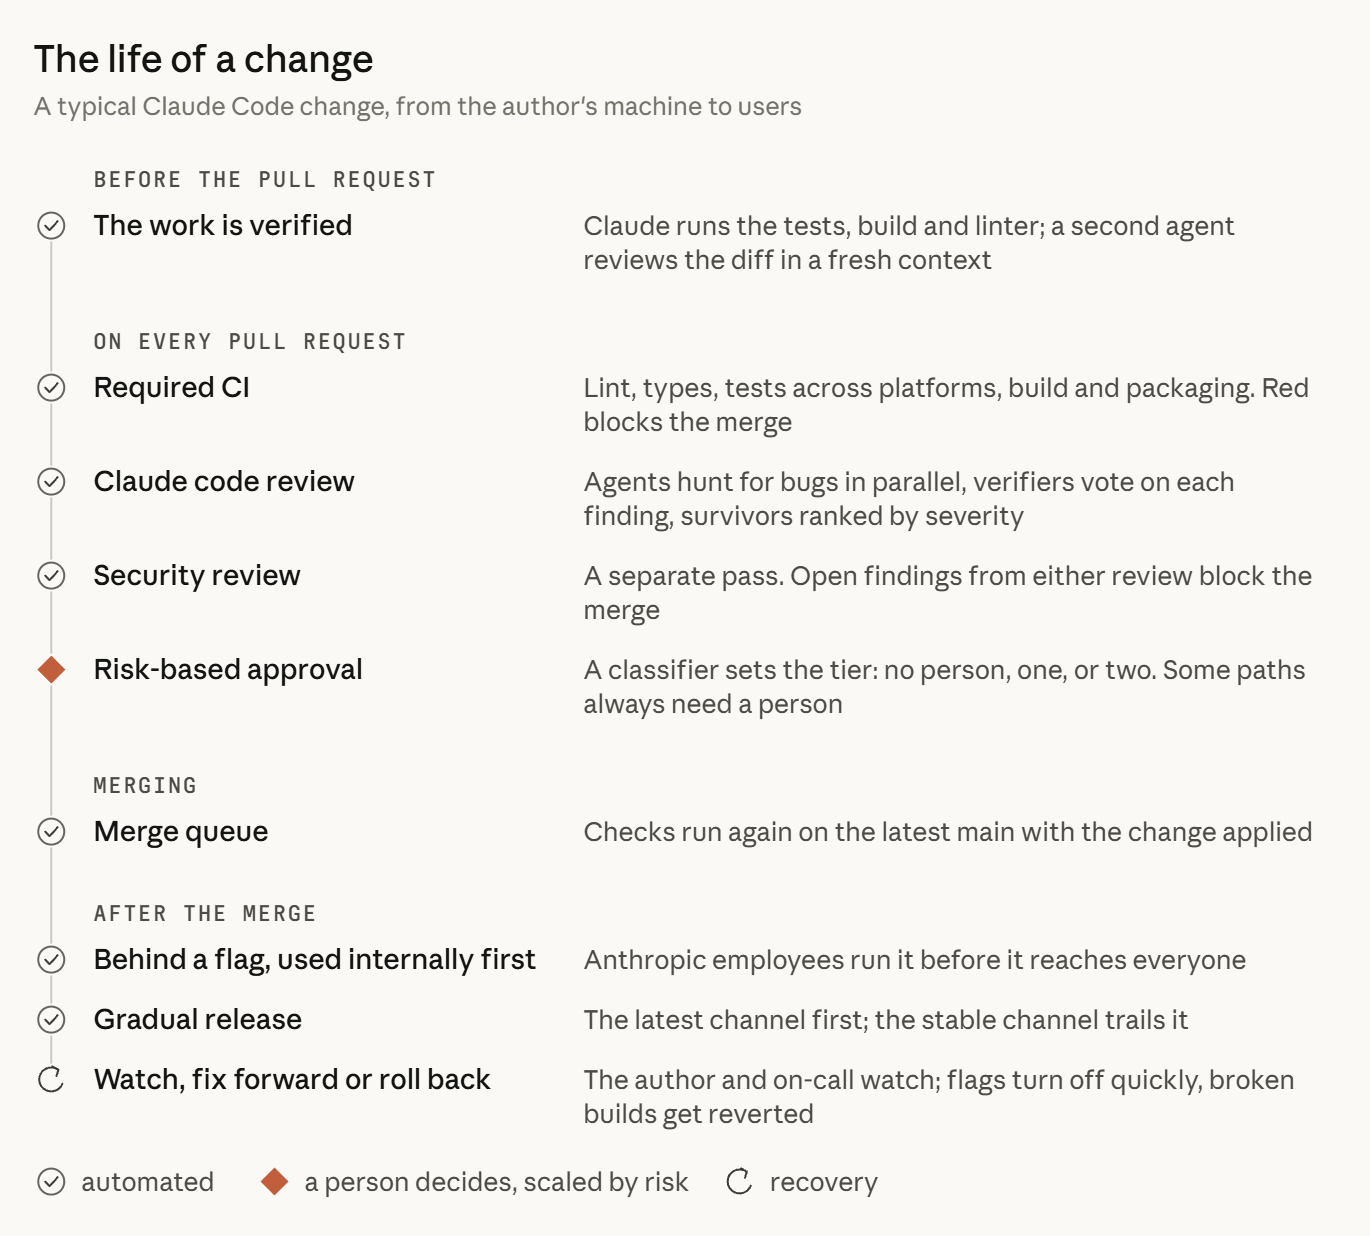
По слоям
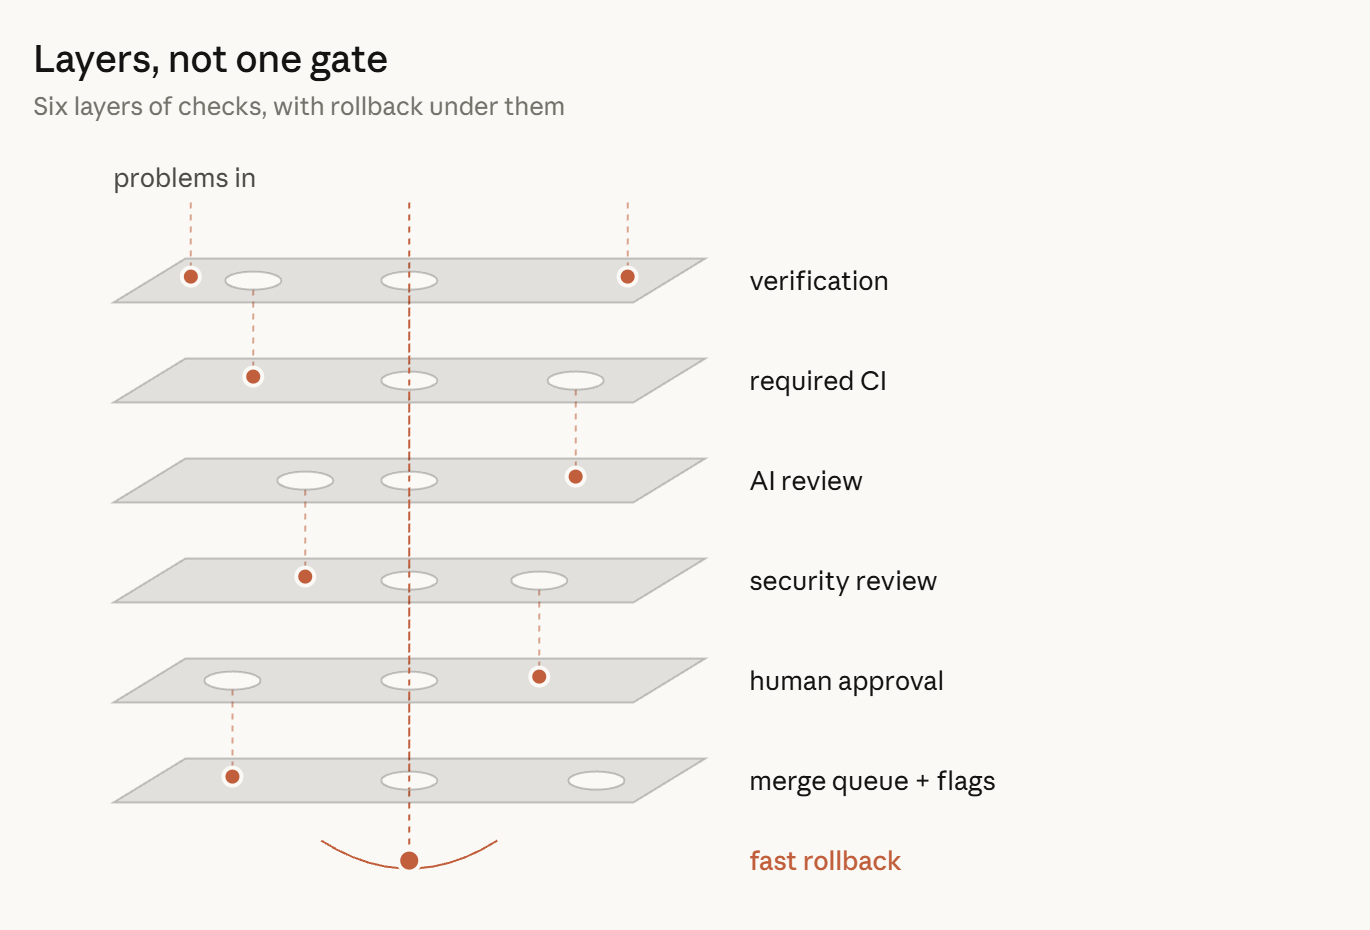
Каждый слой ловит часть проблем и пропускает другие. Очень немногие ошибки проходят через все уровни, а rollback закрывает оставшиеся случаи.
1. Работа проверяется ещё до того, как её увидит кто-то другой
Теперь большая часть ревью происходит ещё до появления PR. Мы даём Claude что-то, что можно реально запустить — например тесты, build или скриншот для сравнения с дизайном — и просим показать результат, а не просто сказать «готово». Затем субагент проверяет diff в свежем контексте. Оба этих подхода взяты из наших лучших практик.
Перед открытием PR многие из нас также запускают несколько внутренних навыков: один ищет баги, другой упрощает diff, третий проверяет end to end поведение. Изменения UI также сверяются с нашими гайдлайнами по дизайну.
Борис Чёрный, создатель Claude Code, называл возможность дать Claude способ проверить собственную работу, вероятно, самым важным фактором для получения хорошего результата. По его оценке, это улучшает финальный результат в два-три раза. Он пишет: «Verification выглядит по-разному в каждой области. Иногда достаточно запустить bash-команду, иногда — тестовый набор, иногда — проверить приложение в браузере или симуляторе телефона».
Если автоматический reviewer постоянно указывает на одну и ту же проблему, мы исправляем источник: навык, правило линтера или файлы инструкций, например:
CLAUDE.mdобъясняет Claude, что представляет собой проект: stack, conventions, goals и non-goals. Каждый ревью загружает этот файл, поэтому в большой кодовой базе мы держим его коротким и ссылаемся из него на другую документацию. Reviewer также отмечает код, нарушающий правила из этого файла, и изменения, из-за которых какая-либо строка в нём устарела.REVIEW.md, написанный владельцами кода, объясняет ревьюверу, что важно именно в их части кода. Мы отдельно проверяем, действительно ли reviewer следует этим инструкциям. ХорошиеREVIEW.mdкороткие. Они описывают, как выглядит ошибка в конкретном репозитории, ограничивают количество мелких замечаний, перечисляют пути, которые нужно пропускать, и требуют указывать конкретный файл и строку как улику вместо догадки по имени. Также они требуют резюме, которое начинается с количества проблем и прямо говорит, если исправлять нечего.
2. AI review на каждом pull request
Каждый pull request проходит Claude review до того, как его посмотрит человек. Claude читает diff в контексте всего репозитория и заявленной цели PR и спрашивает: решает ли изменение заявленную проблему, вписывается ли в систему и не ломает ли что-то ещё?
Если это bug fix, он ищет источник проблемы. Публичная версия, Code Review for Claude Code, теперь общедоступна на тарифах Team и Enterprise, а /code-review запускает облегчённую версию локально.
После запуска research preview доля внутренних PR, получавших содержательные review comments, выросла с 16% до 54%. В большинстве PR размером более 1000 строк находятся проблемы, а большинство небольших возвращаются чистыми. Администраторы могут установить для каждого репозитория режим Quick, Standard или Deep. Deep оправдан там, где пропущенный баг стоит дороже дополнительного времени на ревью.
Перед тем как обнаруженные проблемы попадут к людям, их проверяют другие агенты. Несколько агентов параллельно ищут баги. Затем отдельная группа голосует по каждой находке, и она публикуется только в том случае, если достаточно агентов согласились, что проблема реальна. Находки, касающиеся только стиля, диагностики или очистки, отбрасываются. Мы A/B-тестировали эти фильтры на собственных PR. В итоге оставшиеся замечания появляются как inline комментарии, отсортированные по важности. Каждое помечается как Important, Nit или Pre-existing, чтобы баг, существовавший до PR, не выглядел ошибкой автора.
На каждое обнаружение необходимо ответить. Либо вы его исправляете, либо закрываете поток с объяснением. Часто агент забирает исправление ночью, поэтому утром автор возвращается к PR, который уже прошёл ещё один цикл проверки.
3. Security review, способный заблокировать merge
Для безопасности существует отдельный автоматизированный ревью. PR нельзя мерджить, пока остаётся открытым хотя бы одна обнаруженная проблема из bug review или security review. Нужно либо исправить проблему, либо закрыть поток с коротким объяснением, если это положительно позитивный сбой.
Если следующий коммит устраняет проблему, finding закрывается автоматически. Такой же процесс можно настроить через open-source security review GitHub Action или команду /security-review.
4. Автоматические проверки, которые блокируют merge
Обычный набор: lint, type checks, тесты на каждой платформе и билд. Типичный CLI pull request может пройти десятки проверок ещё до того, как его увидит человек. PR template спрашивает, как изменение тестировалось и как его откатить. Claude может заполнить эти поля, но человек, который инициировал изменение, подтверждает их.
5. Человеческое подтверждение в зависимости от риска
Исправление документации и изменение автоматического обновления несут разный риск, поэтому и ревью у них разный.
| Риск | Примеры | Человеческое подтверждение |
|---|---|---|
| Низкий | Docs, copy, internal-only features, additive changes behind a flag | Не требуется после успешного автоматического ревью и проверок безопасности |
| Средний | Обычные продуктовые изменения и изменения чувствительных областей вроде кеширования, автоматического обновления или системных промптов | Один человек |
| Высокий | Код с самым высоким риском и небольшой набор путей, для которых всегда нужны двое | Два человека |
Уровень определяет само изменение, а не автор. Классификатор читает изменение и выбирает уровень риска. Второй классификатор спрашивает, нужен ли конкретному изменению дополнительный человек даже в том случае, если его уровень этого не требует. Некоторые пути всегда требуют участия человека: всё, что оунеры обозначили как важное, а также любые файлы потоков CI.
Только доверенные авторы получают облегчённые пути. Только авторы из списка доверенных авторов репозитория — в основном команда-владелец — могут использовать более лёгкие правила. Всем остальным нужен второй человек. Одобрение от агента никогда не считается человеческим. Автоматическое ревью может разрешить изменения с низким риском, но не может занять слот, где требуется человек.
Тот, кто дал агенту prompt на изменение, отвечает за него. Если PR написан агентом, человек, который направлял агента, считается одним из требуемых ревьюверов — так же, как если бы он сам написал код.
Одобрение относится к одному конкретному коммиту. Если после этого появляются новые коммиты, которым система не может доверять, одобрение нужно получить заново.
6. Merge queue, флаги и постепенный релиз
Merge queue повторно запускает все проверки на актуальном main уже с применённым изменением, поэтому два PR, которые проходят отдельно, не могут вместе сломать main.
Новое поведение обычно сначала включается за фиче-флагом только для сотрудников Anthropic, и активное внутреннее использование часто обнаруживает регрессию до того, как она доберётся до пользователей. Публичные релизы сначала идут в latest channel. Стабильный канал получает их позднее.
7. Быстрое обнаружение и быстрый rollback
Некоторые ошибки всё равно пройдут через все уровни, поэтому последний слой посвящён тому, чтобы заметить их как можно быстрее. Фиче-флаги выключаются без деплоя. В Claude Code есть недельная on-call ротация, а после инцидентов команда разбирает, какой именно слой должен был поймать проблему.
Выявление неудачного слияния по-прежнему зависит от автора и дежурного, а также от панелей мониторинга откатов и инцидентов. У нас пока нет механизмов, которые бы ужесточали процедуру утверждения при изменении этих показателей; инженеры хотят их внедрить до того, как всё больше кода перейдёт к слияниям без участия человека.
Один коллега сказал, что замедление действительно снижает число ошибок, но в основном потому, что вы просто делаете меньше вообще всего. Мы предпочитаем быстрее замечать и исправлять проблемы.
Как мы улучшаем ревьювер
Наш процесс code review постоянно улучшается по циклу.
Любые инциденты теперь подлежат оценке. Команда собрала старые PR, вызвавшие инциденты, вместе с fix-forwards и reverts, а инженеры, знакомые с этим кодом, подтвердили каждый баг и его местоположение. Ревьювер ежедневно прогоняется по этому набору.
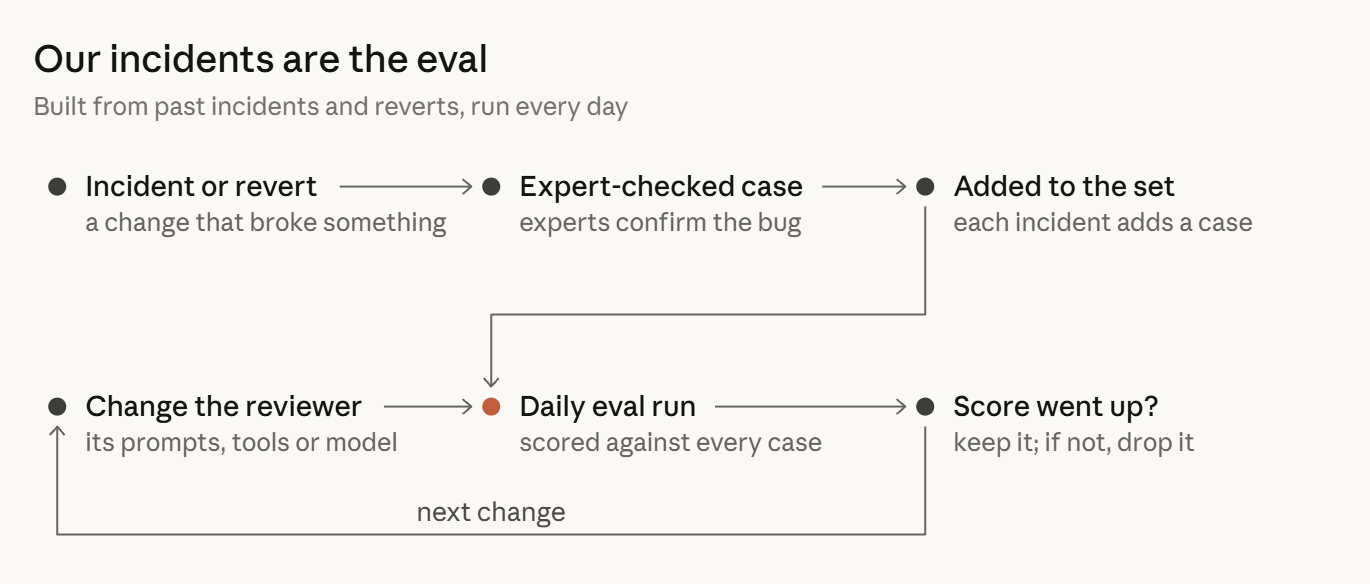
Мы измеряем шум по тому, как люди реагируют на комментарии. Легко поймать больше багов, если не бояться помечать много не-багов, поэтому нужен контроль. Мы классифицируем каждый комментарий ревьювера по реакции человека в PR: исправил, сказал, что это ошибка ревьювера, объяснил, что поведение намеренное, или решил, что проблема несущественна. Также мы запускаем ревьювер на PR, которые точно считаем чистыми, и считаем, как часто он сообщает что-то, что привело бы к вредному изменению.
Шум стоит дороже, если автор — агент. Человек может проигнорировать nit за несколько секунд. Агент его исправит, а значит появится новый коммит и ещё один раунд ревью.
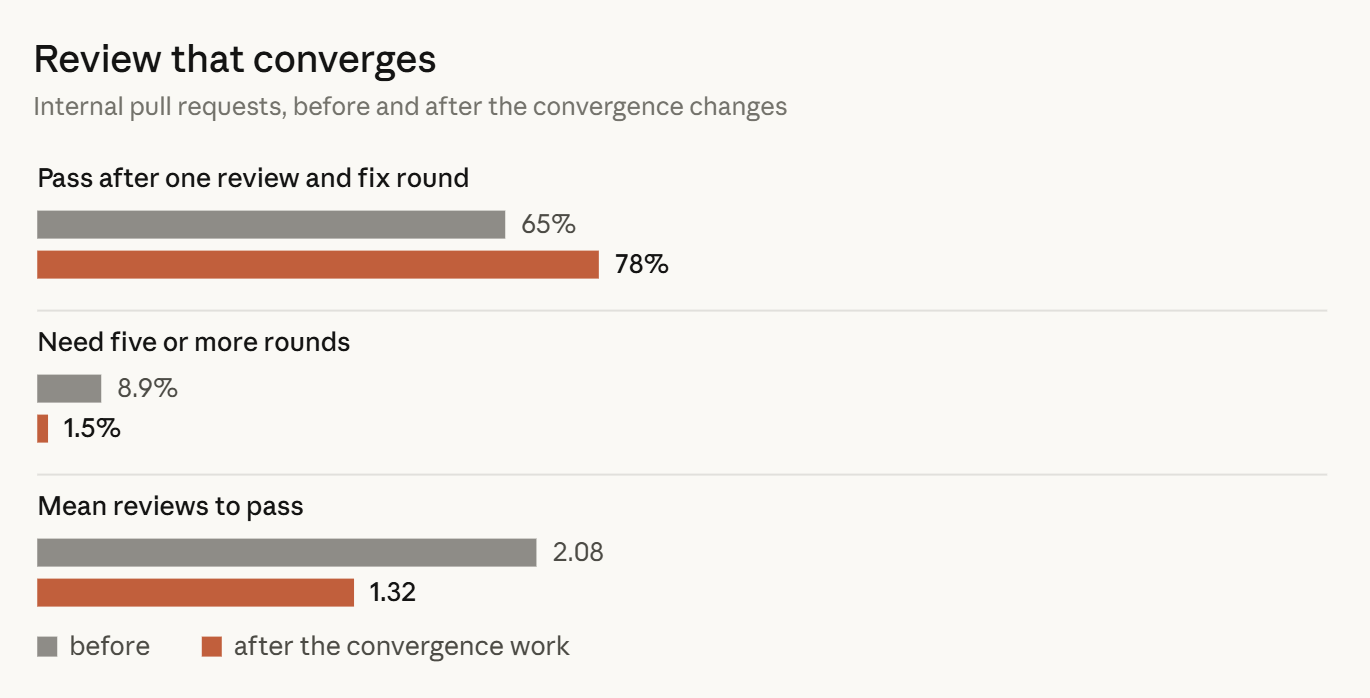
Ревью должно сходиться. Агент-автор и агент-ревьювер могут бесконечно занимать друг друга. Один CLI PR прошёл более 50 циклов ревью и исправлений за ночь, прежде чем автор остановил процесс.
Когда мы запустили git blame на код, который ревьювера продолжал помечать, оказалось, что примерно 59% его замечаний относились к коду, существовавшему ещё во время первого ревью. Reviewer редко находил новые баги — чаще он находил ещё несколько старых на каждом проходе.
Мы сами усугубили ситуацию. Мы привыкли по умолчанию запускать несколько раундов ревью, потому что каждый новый проход находил что-то ещё. Для рискованного изменения это может быть оправдано, но не для каждого PR. Теперь команда отслеживает rounds-to-pass вместе с recall и изменила re-review:
- После трёх раундов, ревьювер просит автора остановиться и переосмыслить подход.
- После первых нескольких проходов re-review проверяет только новый diff.
- Ревьювер помечает класс бага, чтобы автор исправлял все его экземпляры, а не одну строку.
- Уже опубликованные находки не повторяются.
Review agents также по ночам проверяют существующий код, помогая находить старые баги.
Где люди в цикле
Выдёргивать senior инженера из глубокой работы, чтобы он поймал рутинную ошибку, намного дороже автоматического ревью. Люди в команде всё ещё отвечают за:
- Принятие решения о целесообразности реализации: определение направления, соответствие стандартам качества и оценка масштаба. Даже в тех командах, где удалось устранить «узкие места» в процессе проверки кода, сохраняется практика ручного контроля для изменений, поступающих извне — чтобы кто-то мог задаться вопросом: «А стоит ли вообще это делать?»
- Проверка критически важных участков кода: систем биллинга, механизмов автоматического обновления, рабочих процессов CI.
- Анализ архитектурных решений, которые задают шаблоны для всей остальной разработки.
- Изучение подтверждающих данных: результатов тестов, выполненных команд и их вывода, скриншотов, заключений рецензента. Если вы не можете четко сформулировать, какие именно риски могут остаться незамеченными при автоматической проверке, — требуйте полноценного экспертного анализа, а не формального одобрения.
- Ответственность за результат: за каждое внедренное изменение отвечает конкретный человек — независимо от того, кто именно написал код.
Как делиться контекстом внутри команды
Вторая задача code review всегда заключалась в распространении понимания кодовой базы. Читая diff коллеги, вы узнаёте, что изменилось и как связаны между собой разные части системы. Если большую часть чтения выполняют машины, как вообще люди будут изучать код?
У нас нет формального процесса для этого. Никто в команде не держит в голове полную модель Claude Code, и мы не думаем, что это вообще необходимо. Когда кому-то нужно понять определённую часть кодовой базы, он просит Claude написать объяснение именно по этому фрагменту. Это занимает несколько минут и отражает код в его текущем состоянии.
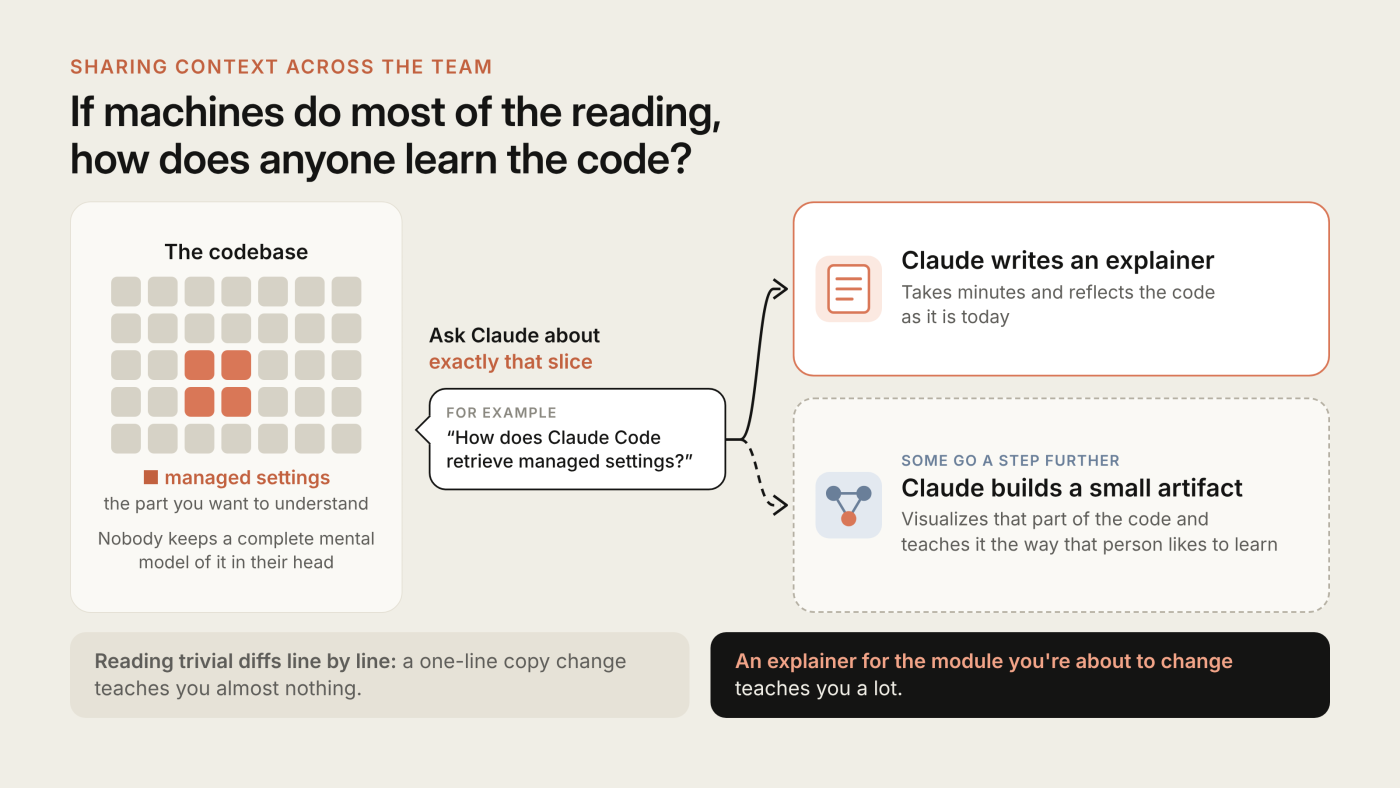
Некоторые из нас идут ещё дальше и просят Claude создать небольшой артифакт, который визуализирует нужный кусок системы и объясняет его в подходящем конкретному человеку стиле.
Если цель — разумно тратить человеческое внимание, это эффективнее, чем построчно читать тривиальные diff. Однострочное изменение текста почти ничего не даёт. Объяснение модуля, который вы сейчас собираетесь менять, даёт значительно больше. Помогает и наша культура работы по умолчанию в открытых Slack-каналах: вы видите, что делают другие, прямо в процессе работы.
«Замерджил— значит, твоё»
Если вы мерджите небольшое или среднее изменение и что-то всё-таки ломается, по командной норме обычно именно вы это и исправляете.
Это работает потому, что:
- Изменения небольшие, поэтому их легко проверять, отлаживать и откатывать.
- Всё обратимо. Использование флагов, отмена изменений и поэтапные релизы позволяют исправить большинство ошибок за считанные минуты.
- Масштаб потенциального воздействия определяет требования к процессу. Для внесения изменений в критически важные части кода привлекается больше специалистов и проводится более тщательная проверка.
- Регрессии быстро обнаруживаются благодаря телеметрии и внутреннему использованию продукта.
- Речь не идет о поиске виноватых. Тот, кто занимается исправлением, обладает наибольшим объемом контекста; при разборе инцидентов основное внимание уделяется системе в целом.
Ответственность за продукт также является общей. Значительная часть команды работает в открытых каналах, где каждый может видеть, над чем трудятся другие, подхватить задачу или — с помощью Claude — заполнить возникший пробел; при этом обратная связь поступает в том числе от тех, кто не является непосредственным автором кода. Такая открытость — важный фактор поддержания высокого качества без необходимости проверять каждую строчку кода.
Когда мы меняем направление
Агенты делают старт новых задач дешёвым, поэтому часть работы вообще не должна попадать в продукт. Обычно кто-то в канале спрашивает «зачем?», напоминает о предыдущем решении или предлагает более простой путь, и автор закрывает либо перерабатывает PR.
Поскольку написать этот код было быстро, закрытие PR не воспринимается как потеря. Главное — предложить другое направление в thread как можно раньше, а не оставлять блокирующий коммент на уже готовом PR.
Как вы можете внедрить этот процесс
Большинство необходимых компонентов уже доступны сегодня.
До pull request
- Дайте агенту проверки, которые он может запускать, перечислите их в коротком
CLAUDE.md, а также добавьте хуки для форматеров и линтеров. - Запускайте
/code-reviewи/security-reviewлокально либо ревью субагента в свежем контексте. - Добавьте
REVIEW.mdи переносите туда повторяющиеся review comments.
На каждом pull request
- Требуйте CI и добавьте в шаблон PR разделы
Testing,RiskиHow to revert. - Добавьте AI ревьювера — Code Review for Claude Code или Claude Code GitHub Action — сначала в один репозиторий, несколько недель настраивайте
REVIEW.md, а затем расширяйте использование. - Добавьте автоматизированный security review и требуйте закрытия каждого review thread до мерджа.
- Сопоставляйте глубину ревью с риском.
- Ограничивайте число раундов ревью; после первых нескольких проверяйте только новый diff.
Утверждение
- Зафиксируйте risk tiers, определяемые самим изменением, а не автором.
- Оставляйте облегчённые approval paths только для авторов, которым доверяете.
- Используйте
CODEOWNERSи branch protection, чтобы auth, billing, CI и release workflows, а также installers всегда требовали участия человека. - Никогда не позволяйте approval бота заменять обязательный человеческий approval, при новых коммитах старые approvals должны сбрасываться.
Merge и после
- Используйте merge queue, feature flags, сначала внутреннее использование, staged releases и rollback в один шаг.
- Превращайте инциденты и октаты в eval set и повторно оценивайте ревьювера при каждом изменении его промптов, инструментов или модели.
- Измеряйте человеческое время, используя revert и incident rates как ограничители.
Куда все движется
В анонсе Code Review говорилось, что approval pull request по-прежнему остаётся решением человека; сам продукт публикует findings, но не approvals. Наши собственные репозитории идут дальше: оунеры могут решать, какие low-risk changes разрешено мерджить исключительно на основании автоматических проверок, и эта граница продолжает сдвигаться.
Когда ревью что-то пропускает, мы спрашиваем, какой информации не было перед моделью, и добавляем исправление в CLAUDE.md, навык или новую проверку. Цель не изменилась: меньше человеческого времени на каждое изменение и не больше откатов, чем раньше.
Если ваша команда позволяет агентам открывать пул-реквесты, нам было бы интересно узнать, какие проверки вы уже автоматизировали, где всё ещё нужен человек и в чём, по вашему мнению, мы ошибаемся.